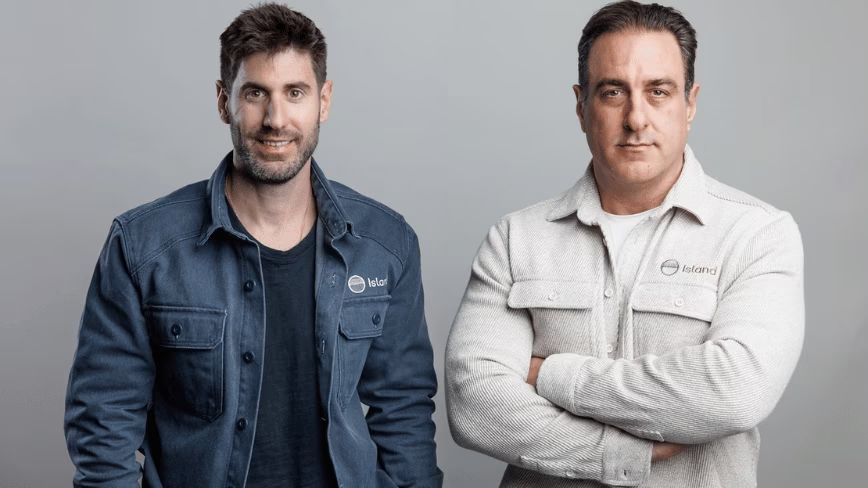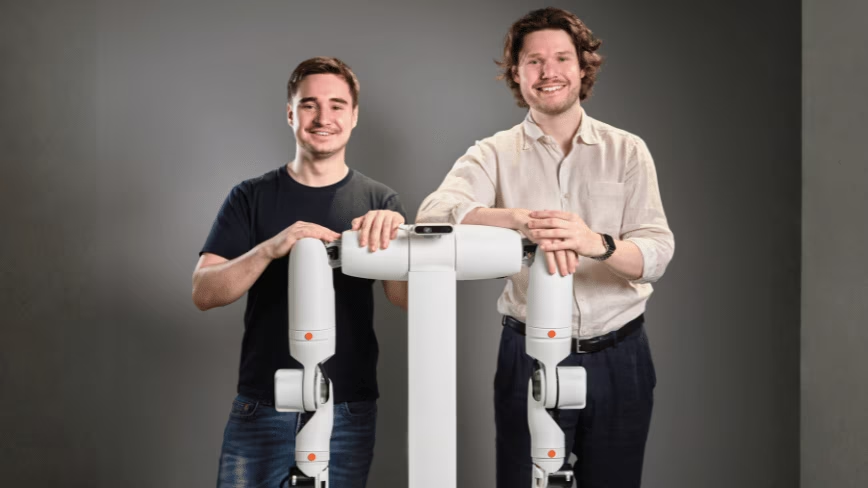
Компания была основана Майком Паппасом и Картером Хаффманом, которые впервые встретились в Массачусетском технологическом институте (MIT), когда Майк помог решить физическую задачу, над которой Картер ломал голову в коридоре. Вскоре они подружились из-за общего интереса к тому, как компьютеры влияют на способность людей общаться.
«Голос становится основным интерфейсом для искусственного интеллекта, и это создает совершенно новый набор проблем, которые невозможно решить с помощью текстовой расшифровки», — заявил генеральный директор и соучредитель Картер Хаффман, сменивший на этом посту соучредителя Майка Паппаса, который теперь занимает должность председателя совета директоров.
Основной продукт компании, Velma, способен анализировать аудиосигналы, улавливая эмоции, тон, намерения, акценты, а также определяя, является ли голос синтетическим. Затем эти различные сигналы можно комбинировать для выявления более сложных инцидентов, таких как попытка мошенничества, случаи домогательств или недовольство клиента, причем это делается в реальном времени во время продолжающегося звонка.
Вместо использования одной большой модели Velma применяет подход, который Modulate называет «ансамблевой моделью прослушивания» (Ensemble Listening Model). Она выбирает и объединяет более 100 небольших специализированных аудиомоделей для каждой конкретной задачи.
Компания заявляет, что этот метод до 1000 раз эффективнее использования одной крупной модели, а Velma в два раза точнее справляется с выявлением реальных проблем по сравнению с универсальными большими языковыми моделями, генерируя при этом в семь раза меньше ложных срабатываний (эти сравнения приводятся самой компанией Modulate).
Результаты публичных бенчмарков проверить проще. В июле модели транскрипции от Modulate заняли первое место среди 88 участников в таблице лидеров Open ASR на платформе Hugging Face, а ее детектор дипфейков с марта удерживает первую строчку в рейтинге Hugging Face Speech Deepfake Arena с показателем равной вероятности ошибки (ERR), составляющим 1,1%. Стоимость пакетной транскрипции составляет 0,03 доллара в час.
Работа с дипфейками развивается на рынке, где клонированные голоса стали общепризнанным инструментом для мошенничества. В Modulate отмечают, что больницы используют ее модели для защиты от звонков с использованием дипфейков, а общая длительность обрабатываемых системами компании аудиозаписей теперь превышает 10 млн часов в месяц (всего проанализировано более 600 млн часов). Компания также предлагает технологию маскировки голоса для защиты сотрудников на должностях с высоким уровнем риска и выявляет случаи груминга в голосовых чатах.
Стив Юрветсон, соучредитель Future Ventures, отметил, что компания «добилась значительного технологического отрыва в сфере аудио-нативного ИИ», а спрос на ее решения стремительно выходит за рамки игровой индустрии, распространяясь на ИИ-агентов, безопасность и клиентский опыт.
Полученные средства пойдут на исследования, инженерные разработки и активное привлечение разработчиков с помощью новых SDK, API и партнерских интеграций, чтобы компании, создающие голосовые продукты, могли покупать технологии понимания аудио, а не обучать собственные модели.
Опубликовано 28 сентября 2026 - 07:30 Наверх