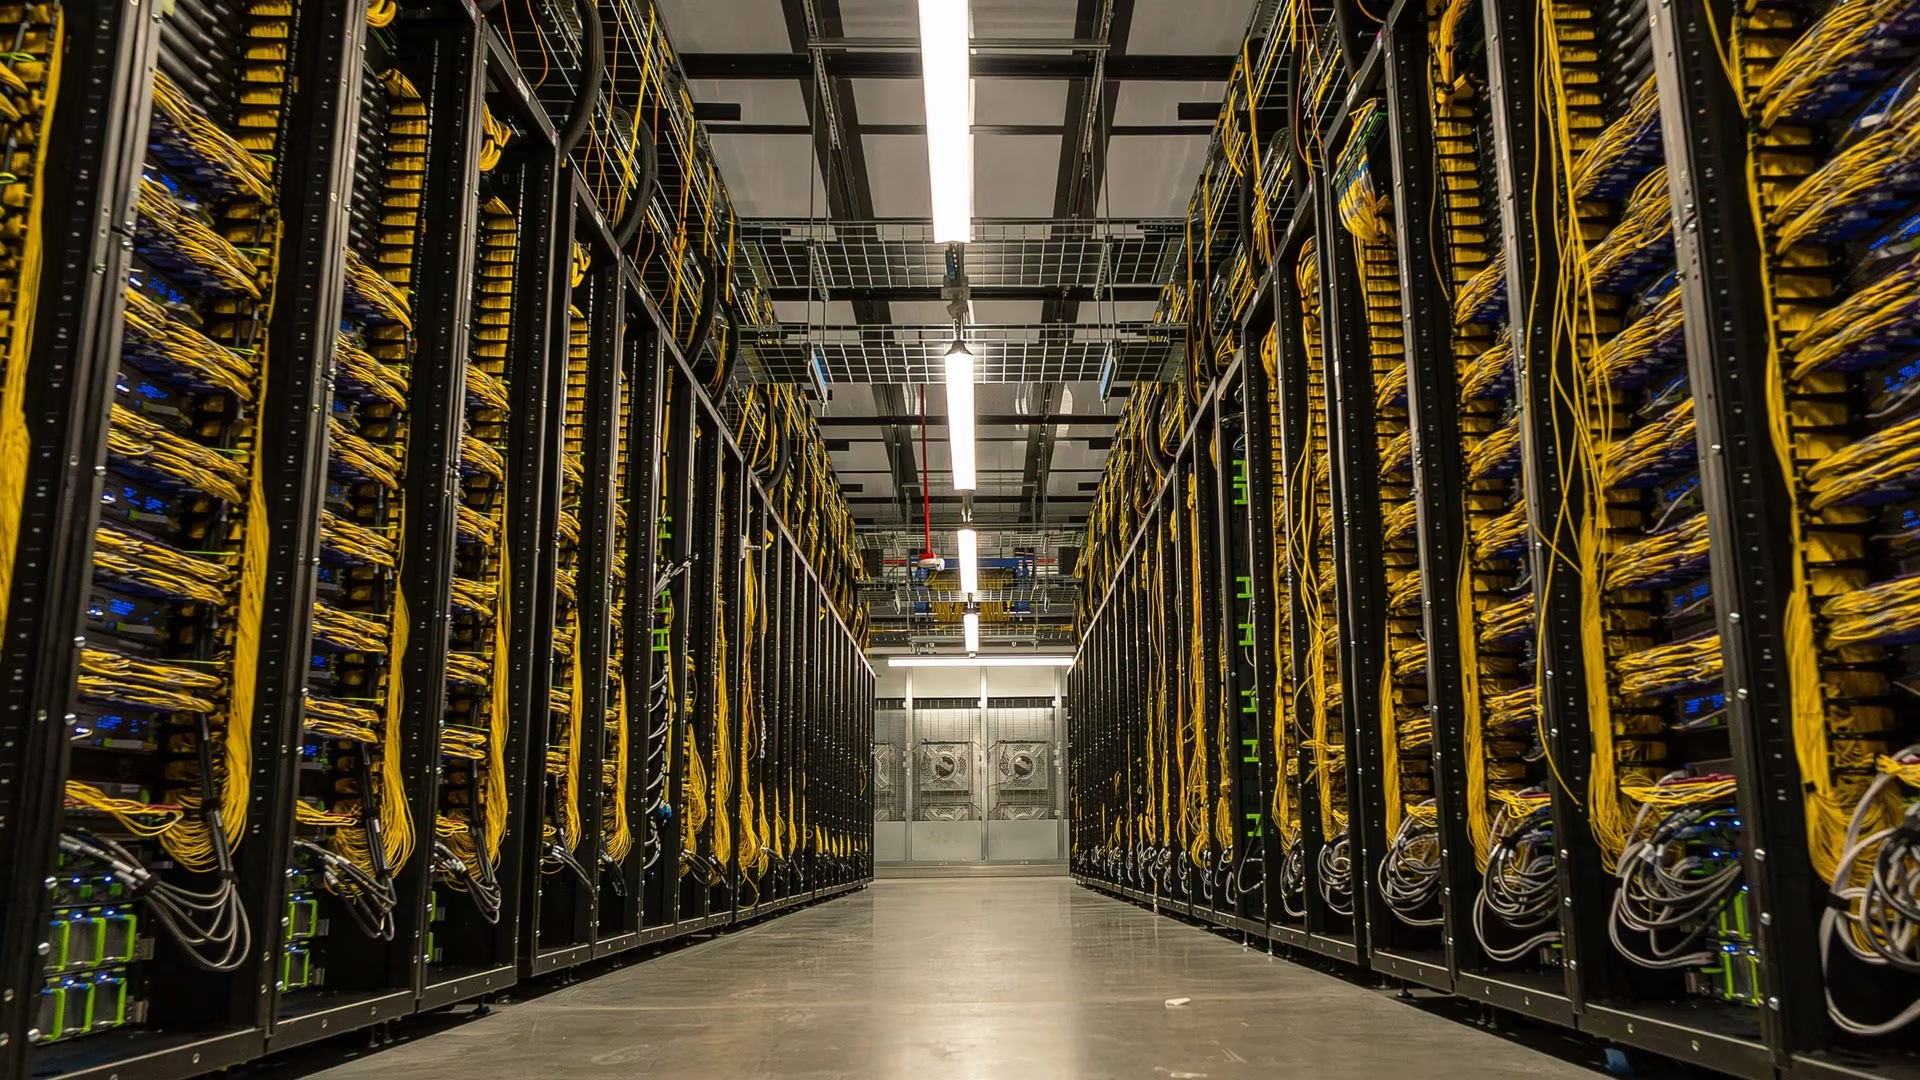
Первый этап создания кластера гигаваттного масштаба завершён. Meta использовала его для обучения семейства моделей Muse, в том числе моделей Muse Wonder. Ещё два года назад на этой площадке работал обычный дата-центр, обслуживавший веб-трафик.
«В полном масштабе Prometheus будет включать примерно 1 миллион распределённых графических процессоров, работающих синхронно», — написала Meta.
Три поколения стоек Nvidia
Сейчас Prometheus работает на двух платформах Nvidia, каждая из которых построена на стойках с 72 графическими процессорами, функционирующими как один ускоритель. Catalina использует GB200 NVL72, а Clemente — более новую GB300 NVL72. На третьей платформе, San Miguel, появятся стойки Nvidia Vera Rubin NVL72.
Графические процессоры размещены в обычных дата-центрах, зданиях, оптимизированных для ИИ, и сооружениях быстрой сборки; все они соединены километрами оптоволокна. Сеть каждого здания связывает до 20 736 графических процессоров. Отдельная агрегирующая сеть соединяет здания на расстояниях от 2 до более чем 100 км. Meta также использует мощности, арендуемые у партнёров.
От 1 000 сбоев в день
В таких масштабах неисправность одной машины может остановить весь процесс обучения. По данным Meta, в середине 2025 года, на первом этапе, число сбоев достигало почти 1 000 событий в день на каждые 8 000 графических процессоров. За год инженерных работ этот показатель удалось снизить на 99%.
Главной проблемой на первых порах стало качество сигнала на более чем 600 000 соединений NVLink между графическими процессорами. По мере наращивания масштабов стоек GB300 всё острее проявлялись сбои памяти.
Во время обучения Muse Wonder кластер обеспечивал продуктивную работу более чем в течение 85% времени предварительного обучения и более чем в течение 90% времени обучения с подкреплением. В среднем он выполнял около 47 000 часов работы графических процессоров между сбоями; после исправлений прошивки этот показатель превысил 54 000. Цель Meta — около 100 000.
За надёжность приходится платить дополнительным оборудованием. Каждая стойка с 72 графическими процессорами задействует 64 из них, а восемь оставляет в резерве; кроме того, Meta держит про запас около 2% стоек. Поэтому для запуска обучения на 32 768 графических процессорах требуется 37 656 — примерно на 13% больше.
Скачки энергопотребления на десятки мегаватт
Когда десятки тысяч графических процессоров синхронно выполняют вычисления и обмениваются данными, энергопотребление кластера колеблется на 30–40%. Запуск или приостановка крупной задачи может за считаные секунды изменить нагрузку на десятки мегаватт. Meta постепенно ограничивает энергопотребление графических процессоров с помощью программного инструмента Dynamo Dimmer, а на уровне стоек, объекта и электросети использует батареи.
По словам Meta, компания оплачивает всю электроэнергию, которую потребляет в Нью-Олбани, и компенсирует её потребление новыми источниками чистой и возобновляемой энергии. В июле компания вышла из соглашения RE100, поскольку развитие газовой инфраструктуры для ИИ опережало рост использования возобновляемых источников.
По словам Meta, следующий суперкластер компании — Hyperion в приходе Ричленд, штат Луизиана, — проектируется с учётом опыта, полученного при создании Prometheus. Meta также пообещала выделить 1 млрд долларов на поддержку сообществ в районах размещения дата-центров.
Опубликовано 20 октября 2026 - 14:08 Наверх