Deep Tech Бизнес Искусственный интеллект
DeepSeek выпускает экспериментальную мультимодальную модель, способную составить конкуренцию Anthropic
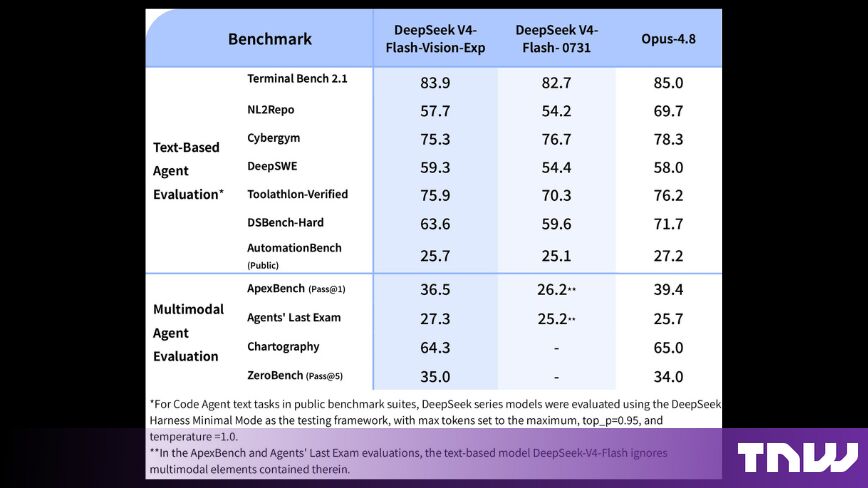
В пятницу компания DeepSeek выпустила экспериментальную мультимодальную модель и заявила, что производительность ее агентов близка к показателям Opus-4.8 от Anthropic. Согласно собственной опубликованной таблице DeepSeek, новая модель превосходит конкурента в трех тестах из одиннадцати.
DeepSeek-V4-Flash-Vision-Exp доступна на API-платформе компании. Она создана на базе текстовой версии V4-Flash и дополнена возможностью распознавать изображения и скриншоты, а также действовать на основе увиденного. Компания из Ханчжоу также выпустила версию 0.1.1 своего набора инструментов (harness) для агентов со встроенной поддержкой.
«Эта экспериментальная мультимодальная модель не уступает DeepSeek-V4-Flash по своим текстовым возможностям, включая работу агентов, рассуждения и общие знания о мире», — написала DeepSeek в X. В тестах мультимодальных агентов она «делает значительный шаг вперед по сравнению с V4-Flash, приближая производительность мультимодальных агентов к уровню Opus-4.8».
Какой именно Opus и почему это имеет меньшее значение, чем кажется на первый взгляд
Opus-4.8 появилась в мае. Компания Anthropic представила Claude Opus 5 24 июля, и издание TNW тогда сообщило, что Opus 5 не уступает Fable в написании кода при вдвое меньшей стоимости.
Opus-4.8 никуда не исчезла. На странице прекращения поддержки моделей Anthropic она числится как Active (активная) — этот статус компания определяет как полностью поддерживаемый и рекомендуемый к использованию, без планов по выводу из эксплуатации ранее мая 2027 года. Такой статус имеют сразу пять моделей семейства Opus.
Таким образом, DeepSeek выбрала актуального, поддерживаемого конкурента, а не заброшенную модель. Чего нет в таблице, так это колонки с Opus 5, и никто другой это сравнение пока не публиковал. Как V4-Flash-Vision-Exp проявляет себя в сравнении с новейшей Opus от Anthropic, попросту неизвестно, и в релизе обратное не утверждается.
Bloomberg сообщил о релизе в пятницу, охарактеризовав Opus 4.8 как передовую модель Anthropic.
Что на самом деле говорят цифры
DeepSeek опубликовала результаты одиннадцати тестов. Ее новая модель опережает Opus-4.8 в трех из них.
Она побеждает в DeepSWE на 1,3 балла, в Agents’ Last Exam — на 1,6, а в ZeroBench — на 1,0. В остальных восьми тестах она отстает. Причем в двух из них разрыв весьма значителен. В NL2Repo у DeepSeek 57,7 против 69,7 (разница в 12 баллов). В DSBench-Hard — 63,6 против 71,7.
Результаты в других тестах действительно близки. В Toolathlon-Verified показатели составляют 75,9 против 76,2. В Chartography — 64,3 против 65,0. В Terminal Bench 2.1 — 83,9 против 85,0.
Один показатель заслуживает внимания скорее как характеристика самой сферы тестирования, а не конкретного состязания. В AutomationBench все три модели набирают около 25 баллов: 25,7, 25,1 и 27,2. Каковы бы ни были сильные стороны современных агентов, данный бенчмарк явно не из их числа.
Мультимодальный скачок имеет оговорку, и ее сделала сама DeepSeek
Главным заявлением стал скачок производительности мультимодальных агентов по сравнению с V4-Flash. В ApexBench этот показатель составляет 36,5 против 26,2, а в Agents’ Last Exam — 27,3 против 25,2.
Часть этого разрыва объясняет сноска в материалах DeepSeek. В этих двух тестах, как утверждается, текстовая версия V4-Flash «игнорирует содержащиеся в них мультимодальные элементы». То есть старую модель оценивали по тестам с изображениями, которые она не способна видеть.
Это не делает результаты новой модели неверными. Но это означает, что скачок отчасти отражает лишь то, что происходит, когда слепую модель проверяют на зрение. DeepSeek раскрыла это прямо в таблице, а не стала скрывать, что делает честь компании — многие лаборатории поступают иначе.
DeepSeek недооценивает один из собственных результатов
Компания заявляет, что версия с поддержкой зрения «не уступает» V4-Flash в работе с текстом. Судя по ее собственным цифрам, модель выступает даже лучше.
Из семи текстовых бенчмарков версия с поддержкой зрения превосходит чисто текстовую модель в шести. В Toolathlon-Verified прирост составил 5,6 балла, в DeepSWE — 4,9, в DSBench-Hard — 4,0. Исключением стал Cybergym: там модель с поддержкой зрения набрала 75,3 балла против 76,7 у предшественницы, то есть добавление зрения стоило ей 1,4 балла в бенчмарке по безопасности.
Все эти цифры предоставлены DeepSeek. Компания заявляет, что оценивала собственные модели с помощью собственного набора тестов в минимальном режиме, при температуре 1,0 и параметре top_p равном 0,95. Бенчмарки от разработчиков — обычное дело, и параметры тестирования раскрыты. И тем не менее, это данные самой компании.
Почему это сравнение важно с коммерческой точки зрения
Все это имеет значение прежде всего из-за цены. Проведенное в этом месяце исследование показало, что V4-Flash является самой дешевой из известных моделей в запуске. Миллион слов у DeepSeek стоит около 87 центов против примерно $50 у Anthropic, и корпоративные покупатели уже заметили эту разницу.
На фоне такого ценового разрыва отставание на один-два балла — это повод для коммерческого спора, а не поражение. Другое дело — проигрыш 12 баллов в NL2Repo. Задачи на уровне репозиториев — это именно то, ради чего компании приобретают ИИ-агентов.
Компания DeepSeek также подтвердила на своем сайте выход официальной версии V4-Pro, обладающей, по ее заявлению, значительно расширенными возможностями агентов, поддержкой API ответов и интеграцией с Codex. Именно эту модель будут реально взвешивать корпоративные покупатели, и ее нет в пятничной таблице.
Читайте заявления, а затем — таблицу
В этом нет ничего необычного. Лаборатории выбирают наиболее выгодные для себя отправные точки. Мы уже видели нечто подобное недавно, когда компания Alibaba назвала Qwen самой скачиваемой открытой моделью в мире, что соответствовало действительности, но с меньшим отрывом, чем утверждалось.
Заявление DeepSeek вполне обоснованно в рамках заданных условий. Было сказано: близко к Opus-4.8, и в ряде тестов модель действительно близка к Opus-4.8. Компания не заявляла о близости к новейшей модели Anthropic и не претендовала на лидерство по всему набору тестов.
Тест, который мог бы поставить точку в споре, имеет название, но не имеет результатов. Кому-то необходимо запустить V4-Flash-Vision-Exp против Opus 5 на том же наборе инструментов. До тех пор честный итог оказывается скромнее заголовков. Экспериментальная китайская мультимодальная модель идет вровень с поддерживаемой американской моделью в большинстве тестов бенчмарка, побеждает в трех из одиннадцати, стоит в разы дешевле и отстает на двенадцать баллов в самой сложной задаче из представленных.