Искусственный интеллект Колонки Технологии
LLM помнят ваш код, а не вашу жизнь: создание переносного слоя персонального контекста
Резюме
Управление контекстом для разработки с помощью ИИ превратилось в развитую экосистему: файлы соглашений, карты репозиториев, банки памяти и полноценные фреймворки памяти — все они борются за то, чтобы удерживать агента программирования в рамках вашей кодовой базы.
Но стоит выйти за пределы терминала и спросить ассистента о вашем здоровье или финансах, как инструменты практически исчезают. Ваш личный контекст хранится либо в функции памяти какого-то одного вендора, привязанной только к нему, либо не хранится вовсе.
В этой статье доказывается, что недостающим элементом является не более умная система памяти, а разделение ответственности: храните персональный контекст в принадлежащем пользователю хранилище, независимому от любого вендора ИИ, и позвольте каждому ассистенту подключаться к нему. Здесь описывается работающая открытая реализация этого принципа — хранилище Markdown на базе Git, обслуживаемое для нескольких интерфейсов LLM через единую удаленную конечную точку MCP, а также компромиссы, на которые идет такая архитектура.
Запуск этой системы на периферийной (edge) инфраструктуре также выявил проблему, которая выходит далеко за ее рамки: периферийные платформы запрещают генерацию кода во время выполнения (runtime), что беззвучно отключает быстрый путь стандартной библиотеки валидации экосистемы TypeScript.
В статье рассматривается решение этой проблемы — компилятор схем с упреждающей компиляцией (ahead-of-time) с открытым исходным кодом, который вырос из этого проекта и теперь проверяет каждый запрос, обслуживаемый системой. Затем в ней рассматривается то, к чему все это движется. По мере того как внешние сервисы предоставляют интерфейсы MCP, чат становится местом, где решаются реальные задачи. Пользовательский слой контекста, не привязанный к конкретному устройству, делает эти действия по-настоящему личными.
В программировании управление контекстом — практически решенная проблема
Если вы пишете код с помощью LLM сегодня, у вас есть огромный выбор способов передачи контекста.
Самый простой уровень — это файлы соглашений: CLAUDE.md для Claude Code, AGENTS.md в качестве кросс-инструментального стандарта, правила Cursor, пользовательские инструкции GitHub Copilot. Каждый серьезный агент программирования теперь читает файл уровня проекта, который подсказывает ему, как работает кодовая база и как себя вести.
На уровень выше располагаются структурные инструменты: карты репозиториев, которые сжимают структуру кодовой базы в контекстное окно, а также индексаторы кодовой базы и интеграции поиска по коду, позволяющие агенту извлекать нужный файл, вместо того чтобы угадывать. Затем идут уровни персистентности (постоянного хранения). Шаблон Memory Bank от Cline сохраняет структурированные заметки о прогрессе между сессиями, Cursor поставляет сессионную память, а Claude Code поддерживает собственный каталог памяти.
Для команд, создающих пользовательских агентов, универсальные фреймворки памяти, такие как mem0, Letta и Zep, предлагают конвейеры извлечения (retrieval), ранжирование и даже темпоральные графы знаний, которые отслеживают, когда тот или иной факт перестал быть истинным.
Результат: агент программирования может проснуться утром, зная вашу архитектуру, ваши соглашения, вчерашнее состояние рефакторинга и то, какие тесты нестабильны. Экосистема переполнена, потому что проблема имеет четкую форму. Код живет в репозиториях, имеет версии и структуру, которую инструменты могут использовать.
Все остальное — второстепенно
Теперь выйдем за пределы терминала. Другая половина использования LLM, пожалуй, большая ее половина, носит разговорный характер: вы бросаете вопрос или проблему в интерфейс чата и хотите получить ответ, основанный на вашей ситуации. Как выглядел тренд моих анализов крови до того, как я изменил диету? Учитывая мой реальный портфель, что это движение рынка означает для меня? Что я решил в прошлый раз, когда оценивал этого вендора? Набросайте это письмо, зная, кто я и что я уже пообещал.
Для такого режима использования инструменты скудны. То, что существует, — это память вендора: ChatGPT помнит вещи о вас внутри ChatGPT, Claude внутри Claude, Gemini внутри Gemini. Каждый из них полезен, и каждый из них представляет собой изолированный бункер (silo).
Память не путешествует; переносимость, если она вообще существует, представляет собой однонаправленную функцию импорта, контролируемую вендором-получателем. Смените ассистента или просто используйте двух, и ваш накопленный контекст распадется на несогласованные фрагменты.
Фреймворки памяти, которые так хорошо служат агентам программирования, тоже не восполняют этот пробел. mem0, Letta и Zep — это инфраструктура для разработчиков: это то, к чему вы обращаетесь, когда создаете продукт-агент, а не когда вы — человек, который хочет, чтобы его собственный контекст следовал за ним из чата на ноутбуке в чат на телефоне или сеанс программирования.
И они хранят память в собственных хранилищах, что воссоздает проблему привязки к вендору на уровень ниже: вы сбежали из бункера ChatGPT в бункер стартапа.
Поэтому вопрос, который стоит задать, звучит не как «какая функция памяти лучше?», а так:
Почему мой контекст вообще живет внутри ассистента?
Отделите хранилище от вендора
Ответ, который предлагает эта статья, стар как мир: разделение ответственности. Персональный контекст должен представлять собой хранилище, принадлежащее пользователю, в формате, который может прочитать любой инструмент. Ассистенты должны быть клиентами этого хранилища, но никак не его владельцами.
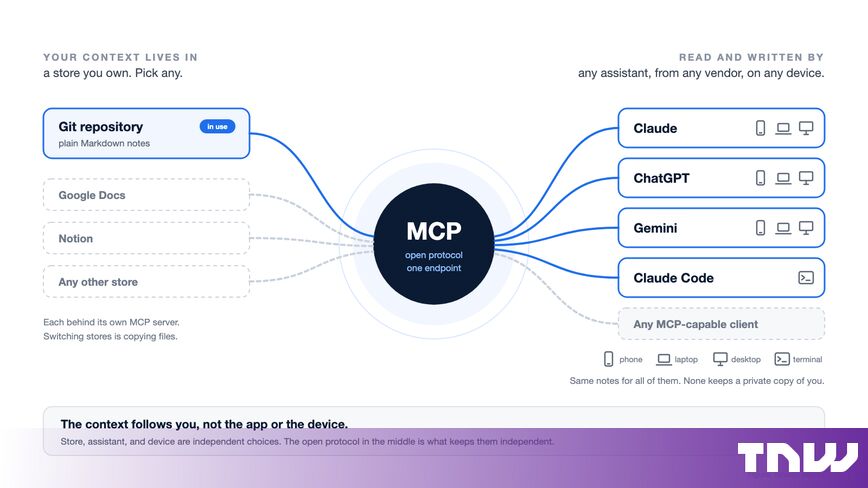
Моя реализация этого принципа — частный репозиторий GitHub с простыми заметками в формате Markdown, организованными как хранилище Obsidian, чтобы заметки формировали связанный, доступный для просмотра граф. Он предоставляется каждой используемой мной LLM-поверхности через единую аутентифицированную конечную точку, использующую Model Context Protocol (MCP).
MCP важен здесь потому, что это открытый протокол, а не проприетарный SDK вендора: один сервер, а claude.ai в веб, десктопное приложение, телефон и Claude Code в терминале — все они читают и записывают одни и те же заметки. В принципе, к нему может присоединиться любой клиент с поддержкой MCP от любого вендора. Эта система, vault-mcp, имеет открытый исходный код, и я ежедневно использую ее для заметок по проектам, рабочего контекста и личных логов.
Никто не дарует эту нейтральность. Она проистекает из самого хранилища: корпус представляет собой простой текст в репозитории Git, поэтому уход от любого вендора или от всех них сразу стоит ровно команды git clone. вы никогда не подаете запрос на экспорт и не ждете, пока две компании договорятся о формате миграции.
Это же свойство делает контекст читаемым: то, что мои ассистенты знают обо мне, представляет собой папку с файлами, которые я могу открыть, прочитать, отредактировать и сравнить (diff). Память вендоров только сейчас догоняет этот стандарт прозрачности.
GitHub и Markdown — это просто мой выбор, и этот принцип от них не зависит. Он требует лишь того, чтобы контекст жил вне ассистента, в хранилище, контролируемом пользователем, доступном через MCP. Храните свои заметки в Google Docs и предоставляйте их через MCP-сервер Docs, и эта же архитектура сохранится.
Если ваши заметки уже хранятся в Notion, подключите его MCP-сервер и используйте его. Каждый выбор меняет баланс компромиссов (репозиторий Git с простым текстом максимизирует переносимость и проверяемость, в то время как хостинговое рабочее пространство жертвует частью этого ради знакомства с инструментом и встроенного редактирования), но именно разделение выполняет всю работу.
Формат тоже помогает: до тех пор, пока сами заметки представляют собой чистый Markdown, хранилище подлежит замене, поскольку миграция — это просто копирование файлов. Вы можете начать на GitHub сегодня и перенести тот же корпус в любое другое хранилище, какое пожелаете, завтра. Что бы вы ни выбрали, каждый ассистент становится клиентом этого хранилища, а не хранит вашу частную копию.
Стоит вкратце упомянуть несколько архитектурных решений, поскольку они обеспечивают модель безопасности, а не просто базовую обвязку. Сервер работает на бессерверной периферийной (serverless edge) инфраструктуре и использует API GitHub в качестве транспорта, поэтому никакой персональный компьютер не должен работать постоянно, а вся система укладывается в бесплатные тарифные планы. Записи доступны только для добавления: ассистент может создать или перезаписать заметку, но никогда не может удалить ее.
Каждое изменение попадает в виде коммита Git, поэтому история доступна для аудита, а любую запись можно откатить. Аутентификация разделяет понятия «кто может подключиться» и «к чему сервер может прикасаться» на две отдельно ограниченные учетные данные (credentials), что ограничивает радиус поражения в случае утечки любой из них.
Существует и более тонкий риск. Предоставление всей вашей личной базы знаний для LLM превращает ваши собственные заметки в ненадежный канал ввода, поскольку скрытая инструкция в заметке может стать промпт-инъекцией в тот момент, когда модель прочитает ее.
Поэтому сервер рассматривает извлеченные заметки как данные, а не как инструкции, используя правила добавления только в конец и ограничения путей в качестве защитных механизмов. Ничто из этого не зависит от конкретного стека. Суть в том, что слой персонального контекста заслуживает консервативных настроек по умолчанию, потому что полезная нагрузка — это все, что вы знаете.
Что забрала периферия и что потребовалось, чтобы вернуть это назад
Запуск на периферийной инфраструктуре был правильным решением для системы, которая не должна ничего стоить и не должна зависеть от какого-то персонального компьютера. Но этот выбор потребовал жертвы на неожиданном уровне: валидации входных данных.
MCP-сервер — это общедоступный API. Каждый вызов инструмента, который делает ассистент (прочитать эту заметку, записать ту, найти этот термин), поступает как ненадежный ввод и должен быть проверен до того, как он коснется хранилища.
В мире TypeScript стандартным инструментом для этого является Zod — библиотека валидации, приближающаяся к ста миллионам загрузок в неделю, и официальный SDK MCP построен вокруг нее. vault-mcp не исключение: каждый запрос проходит через схему Zod, прежде чем произойдет что-либо еще.
Текущая версия Zod работает быстро, и причина кроется в ее внутренностях. Первый раз проверяя форму конкретного объекта, она генерирует специализированный JavaScript для этой конкретной формы «на лету» (runtime) и компилирует его на месте; каждая последующая валидация выполняет специализированный код вместо интерпретации схемы. Это миниатюрный компилятор Just-In-Time.
Периферийные среды выполнения (edge runtimes) категорически запрещают это. Генерация кода во время выполнения представляет собой угрозу безопасности в мультиарендной среде, поэтому такие платформы, как Cloudflare Workers, блокируют ее на корню.
Zod знает об этом: библиотека определяет Workers по имени и отключает свой быстрый путь, возвращаясь к медленному интерпретируемому маршруту. Таким образом, среда, в которой живет вся эта система, оказывается единственной средой, где самый быстрый валидатор экосистемы не может работать на полную мощность.
Это ограничение не уникально для персональной базы знаний. Оно применимо ко всем, кто проверяет входные данные на периферии, а периферия — это то место, где обрабатывается все большая часть запросов в Интернете.
Исправление следует из того же наблюдения, которое изначально побудило Zod использовать JIT: схемы статичны. Они пишутся один раз, во время разработки, и никогда не меняются во время работы сервера. Если специализация при первом использовании незаконна на периферии, специализируйте код раньше, на этапе сборки, где нет никаких ограничений. Я создал Zod AOT — компилятор с открытым исходным кодом, который преобразует схемы Zod в простые, плоские функции валидации JavaScript во время сборки. Поскольку во время выполнения код не генерируется, скомпилированные валидаторы работают везде, включая среды, где собственный быстрый путь Zod отключен. Поскольку при первом запросе ничего не компилируется, нет штрафа за холодный старт, что важно на бессерверных платформах, которые постоянно создают и уничтожают экземпляры. В бенчмарках скомпилированные валидаторы проверяют сложные вложенные объекты до 60 раз быстрее, чем быстрый путь Zod во время выполнения, и этот разрыв еще больше увеличивается на периферии, где этот быстрый путь вообще никогда не работает. Схемы, в которые встроены произвольные функции и которые не могут быть полностью скомпилированы, компилируются частично, а оставшаяся часть возвращается к неизмененному Zod.
Теперь vault-mcp проверяет каждый вызов инструмента с помощью этих предварительно скомпилированных валидаторов. Скорость радует, но более полезным результатом является общий вывод: ограничение, с которым столкнулись при создании персонального инструмента, привело к исправлению, применимому ко всему классу систем, и обе половины имеют открытый исходный код.
Куда все движется: чат как фронтенд ко всему
Аргументы в пользу отделения хранилища от вендора становятся все более убедительными по мере того, как внедрение MCP выходит за рамки персональных инструментов. MCP становится стандартным способом подключения LLM как к сервисам, так и к контексту, и каждый внешний сервис, предоставляющий интерфейс MCP, превращает разговор в место, где делаются реальные дела.
Электронная коммерция — очевидный пример. Если платформа онлайн-покупок предоставляет поиск товаров и оформление заказа через MCP, ассистент может найти, сравнить и купить товар в рамках одного разговора. Именно здесь слой персонального контекста меняет качество транзакции. Ассистент, способный читать ваши заметки, знает ваши размеры, ваш бюджет, что вы купили в прошлом году и пожалели ли об этом, а также что у вас уже есть. Он может предложить правильный продукт или посоветовать вообще ничего не покупать, чего никогда не сделает ни один рекомендательный движок витрины магазина, поскольку эти движки оптимизированы для продавца. Доступ к инструментам делает ассистента способным. Ваш контекст — это то, что делает его советы личными.
Примут ли это поставщики услуг — открытый вопрос. Оформление заказа через MCP сокращает время пребывания на сайте и обходит стороной мерчандайзинг, рекламу и продажи дополнительных услуг — те механизмы, на которых строится выручка электронной коммерции. Некоторые платформы будут сопротивляться превращению в headless-бэкэнд для чужого ассистента; другие могут решить, что доступность там, где клиент уже находится, лучше защиты целевого веб-сайта. Независимо от того, как это повернется, пользователь ничего не теряет, владеючи слоем контекста: он подключается к любым открывающимся сервисам.
Второе следствие стандартизации на MCP — независимость от устройств. Ничто в удаленном хранилище контекста не предполагает обязательное наличие ноутбука или телефона; это просто сегодняшние поверхности. Связь между ассистентом и контекстом представляет собой протокол, поэтому она не зависит от какой-то конкретной платформы. Когда появится следующая категория устройств (умные очки, носимые устройства, домашние гаджеты, автомобиль), любой размещенный на них ассистент сможет обратиться к тому же хранилищу точно так же, как настольные и мобильные клиенты делают это сейчас. Нечего мигрировать или переимпортировать, и нет памяти для каждого устройства, начинающейся с нуля. Слой контекста, построенный на открытом протоколе, переживет как выбор вендоров, так и поколения устройств.
От чего приходится отказываться
Эта архитектура имеет реальную цену. Здесь нет ранжированного извлечения и темпоральной модели, которая знает, когда срок действия факта истек; специализированные фреймворки памяти лучше справляются с автоматическим поиском больших объемов данных. Для корпуса из сотен заметок одного человека делегирование поиска собственному использованию инструментов ассистентом работает хорошо, и именно на этот масштаб рассчитана данная архитектура.
И сама композиция не является беспрецедентной. Существуют серверы Markdown-over-MCP, как и серверы хранилищ на базе git. Все, на что я могу претендовать, — это конкретная комбинация: хранилище, принадлежащее пользователю, доступ по открытому протоколу, отсутствие постоянно работающего хоста и консервативная семантика записи, объединенные вокруг одного принципа. Ассистент заменяем; контекст — нет.
Выводы
У контекста программирования есть экосистема. У персонального контекста есть бункеры (silos). Файлы соглашений, карты репозиториев, банки памяти и фреймворки памяти отлично подходят для задач программирования. Ничего эквивалентного и нейтрального по отношению к вендорам для повседневного разговорного использования не существует.
Переносимость должна быть заложена в проект с самого начала; ни одна функция вендора не обеспечивает ее. Поместите персональный контекст в текстовый репозиторий, которым вы владеете, и миграция между вендорами сведется к простой команде git clone.
Открытые протоколы делают разделение хранилища и вендора практичным. MCP позволяет хранилищу, принадлежащему одному пользователю, обслуживать множество поверхностей ассистентов (ноутбук, телефон, терминал) без разрешения какого-либо вендора.
Сервисы с поддержкой MCP усилят ценность собственного контекста. По мере того как коммерция и другие сервисы будут предоставлять интерфейсы MCP, ассистенты получат возможность действовать, а персональный контекст превратит общее действие в персонализированный совет. Независимо от того, принимают ли старожилы рынка дезинтермедиацию или сопротивляются ей, принадлежащий вам слой контекста подключается ко всему, что открывается.
Открытый протокол сохраняет слой контекста независимым от любого устройства. Новые категории устройств, такие как носимые гаджеты, очки и домашние устройства, наследуют то же хранилище по тому же протоколу, что и ПК с мобильными телефонами, без необходимости что-либо мигрировать и без сброса памяти конкретного устройства к нулю.
Ограничения периферии отражаются на неожиданных уровнях. Платформы, запрещающие генерацию кода во время выполнения, беззвучно отключают быстрые пути стандартных библиотек; скрытый JIT-компилятор Zod — один из них. Компиляция этой специализации на этапе сборки вместо этого, чем и занимается Zod AOT, восстанавливает скорость в любой среде выполнения и ничего не стоит при холодном старте.
Слой персонального контекста заслуживает консервативных настроек по умолчанию. Записи только на добавление, минимально необходимые привилегии учетных данных и история аудита для каждого коммита стоят недорого при ежедневном использовании и ограничивают то, что может разрушить любой сбой (включая промпт-инъекцию через ваши собственные заметки).
Четко осознавайте, от чего вы отказываетесь. Хранилище, принадлежащее пользователю, жертвует ранжированным извлечением и темпоральным моделированием фактов ради права собственности, читаемости и нулевого обслуживания. Для пожизненного контекста одного человека это правильный компромисс; для высокопроизводительной памяти агентов — нет.
Заключение
Индустрия ответила на вопрос «как LLM должна запоминать?» созданием все более совершенных систем памяти, каждая из которых привязана к вендору или платформе. Для личной, повседневной половины использования LLM это неправильный формат ответа.
Память, которая имеет значение на протяжении десятилетий (здоровье, деньги, решения, отношения, работа), не должна иметь владельца. Отделите хранилище от вендора, дайте каждому ассистенту права клиента и ничего более, и ассистенты станут тем, чем они должны были быть все это время: взаимозаменяемыми представлениями поверх контекста, который навсегда и структурно принадлежит вам.
По мере того как MCP распространяется через внешние сервисы и на любые устройства, которые появятся в будущем, это разделение будет приносить все больше дивидендов. Ассистенты, сервисы и аппаратное обеспечение будут продолжать меняться; контексту под ними больше не придется этого делать.
Тэцуя Вакита (Tetsuya Wakita) — вице-президент по инжинирингу в AnyMind Group в Таиланде, где он руководит глобальной инженерной организацией и создает продукты на базе LLM и инструменты для разработчиков. Он разрабатывает и поддерживает vault-mcp — портативный слой контекста с открытым исходным кодом для ассистентов LLM, а также является автором Zod AOT, компилятора с упреждающей компиляцией для схем Zod.