Критики могут возразить, что Дженсен заинтересован в продвижении более активного использования токенов, так как это напрямую конвертируется в более высокие доходы для Nvidia.
Такой настрой в корпоративной Америке заметен во многих продуктовых компаниях и стартапах. Генеральный директор Databricks Али Годси (Ali Ghodsi) особо отметил одного инженера, который потратил на ИИ-токены более 7000 долларов, в то время как в стартапах вроде Sendbird появилась таблица лидеров, отслеживающая расходы каждого сотрудника на токены.
Стремление к большему потреблению токенов не ограничивается только технологическими компаниями — это происходит повсеместно. Расходы на токены в юридическом ИИ-стартапе Harvey выросли примерно в 12 раз и достигли 12 триллионов токенов в месяц. На данном этапе очевидно, что все хотят увеличить свои расходы на токены, но стоит разобраться в причинах этого явления.
Больше токенов означает больше производительности — по крайней мере, такое утверждение делают энтузиасты ИИ и ранние адепты токенмаксинга. Идет гонка за максимальным количеством потраченных токенов, и компании с радостью оплачивают счета. Внедрение больших языковых моделей (LLM) — это совершенно новый способ работы в различных секторах, и компании, которые не будут развиваться достаточно быстро, останутся позади.
Счет за LLM пришел, и он огромен
После первоначального ажиотажа вокруг токенмаксинга в начале 2026 года мы увидели, как гораздо большее число компаний внедрили лимиты на использование токенов по мере экспоненциального роста затрат.
Одна из самых громких историй в этой сфере произошла в начале 2026 года, когда технический директор Uber Правин Неппалли Нага (Praveen Neppalli Naga) в интервью The Information сообщил, что они исчерпали свой годовой бюджет на ИИ всего за 4 месяца и теперь возвращаются к чертежной доске, чтобы определить дальнейшие шаги.
Как сообщала Сара Перес (Sarah Perez), Uber — далеко не единственная компания, столкнувшаяся с расплатой за превышение бюджета на ИИ. Адам Моссери (Adam Mosseri) из Meta видит будущее, в котором для каждого сотрудника будут установлены лимиты на токены. Они уже внедрили правила для снижения потребления токенов путем сокращения нецелевого использования.
Таблица лидеров по расходам на ИИ, нашумевшая в начале года, уже была закрыта. Microsoft отменила лицензии на Claude Code и объединила всех под эгидой Copilot.
Расплата за тренд токенмаксинга наступила, и важно изучить первопричину этого масштабного роста затрат на балансах предприятий.
Существует несколько факторов, приводящих к росту расходов, связанных с использованием LLM. Некоторые из этих причин связаны с первым в истории столь масштабным внедрением ИИ во всей корпоративной Америке. В 2026 году компании создали внутренние панели мониторинга для отслеживания расходов на ИИ и активно поощряли сотрудников использовать ИИ в повседневных задачах.
Выбор модели имеет решающее значение
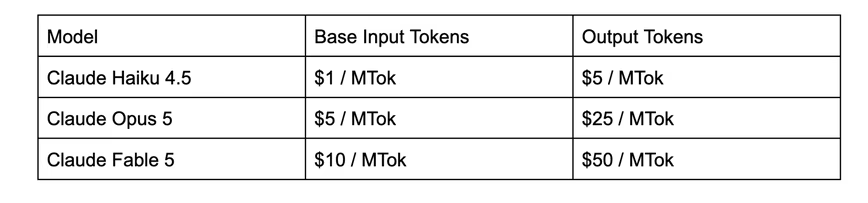
Помимо широкого распространения, одной из главных внутренних причин высокой стоимости токенов является выбор модели. Модели высшего уровня обходятся в 5–10 раз дороже своих более оптимизированных аналогов.
В следующей таблице представлен подробный обзор оптимизированных моделей Claude и моделей верхнего уровня. Все цены указаны из расчета за миллион токенов. Обратите внимание, что цены актуальны на июль 2026 года и могут измениться, но они все равно помогают донести главную мысль.
Если взять Haiku за отправную точку, мы заметим, что Opus 5 в 5 раз дороже. Новейшие флагманские модели обходятся еще дороже: такие модели, как Fable 5, в 10 раз дороже оптимизированной модели вроде Haiku. Эти различия в ценообразовании подчеркивают выбор модели как одну из лучших стратегий оптимизации затрат.
Для борьбы с растущими расходами, связанными с высоким потреблением токенов, компаниям рекомендуется тщательно подходить к выбору моделей. Крупные передовые модели вроде Opus рекомендуются для сложных сеансов программирования, в то время как такие модели, как Haiku, подходят для быстрых поисковых запросов и задач подзадач (subagent).
Большое окно контекста увеличивает затраты
В рамках одной и той же по размеру передовой модели, такой как Opus 5, большое окно контекста выступает важнейшим фактором общих затрат. Проще говоря, окно контекста — это оперативная память LLM для конкретного сеанса, которая включает промпты, историю беседы, извлеченные документы и ответы модели. Увеличение размера окна контекста вдвое может учетверить необходимый объем вычислений.
Чтобы оценить влияние потребления контекста на стоимость, я проведу простой тест. Будут запущены два идентичных сеанса Claude. Будет задан один и тот же вопрос, но с той разницей, что в один из сеансов в окно контекста будет загружена «Одиссея» Гомера.
В обоих сеансах прозвучит ответ на один и тот же вопрос: «Кто такая Калипсо и почему она держала Одиссея в плену?»
Этот вопрос о художественном произведении выбран потому, что объем текста составляет 132 953 слова, что приблизительно равно 177 000 токенов. По сравнению с сеансом программирования, где могут загружаться новые зависимости и проверяться сторонние пакеты, такой метод передачи контекста в сеанс приводит к предсказуемому объему потребления контекста.
Сеанс Claude, в который текст не скопирован, сможет выполнить поиск в интернете и ответить на вопрос при минимальном потреблении токенов. В следующей таблице указано потребление токенов в обоих сеансах.
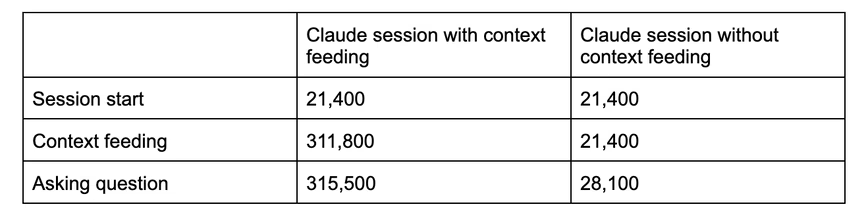
Столь большая разница в потреблении токенов выливается в значительную разницу в стоимости сеансов.
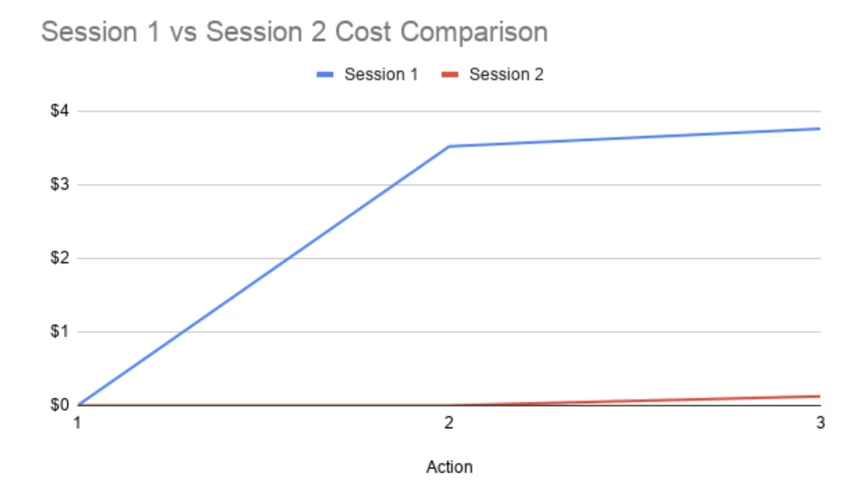
Интересно отметить, что без передачи контекста задаваемый обоим сеансам Claude вопрос одинаков, однако стоимость каждого сеанса демонстрирует существенную разницу.
Для одного и того же вопроса сеанс с передачей контекста обошелся в 0,24 доллара, в то время как сеанс без контекста — всего в 0,12 доллара. По мере продолжения сеанса эта стоимость превращается в базовую надбавку к каждому новому запросу к LLM. Ответ, полученный в сеансе со всем контекстом, оказался более подробным и качественным, но обошелся в 2 раза дороже.
Для многих практических приложений необходимо передавать именно тот контекст, который требуется LLM, но найти золотую середину — гораздо более сложная задача. В определенный момент пользователь жертвует контекстом и бюджетом ради качества ответа. Постоянное увеличение окна контекста не является жизнеспособным вариантом, и такие модели, как Haiku, предотвращают эту проблему, ограничивая окно токенов до 200 тысяч.
Максимизация результатов >> максимизация токенов
Выбирая крупные модели для каждой задачи и дополняя сеансы лишним контекстом, пользователи могут легко завысить свои счета за LLM. В корпоративной Америке существовали стимулы, побуждающие пользователей активнее использовать ИИ.
У тренда токенмаксинга есть критики, которые утверждают, что потраченные токены — это несовершенная метрика, и, как сообщает Бускетт (Bousquette), нам следует рассчитывать рост производительности, связанный с использованием LLM. Ямини Ранган (Yamini Rangan), генеральный директор HubSpot, лучше всего резюмировала это в своем посте в LinkedIn: «Максимизация результатов >> максимизация токенов».
Тренд токенмаксинга похож на начало 2000-х годов, когда компании подсчитывали строки написанного кода. Объем создаваемого кода или просматриваемых документов в лучшем случае является косвенным показателем, а в худшем — ошибочной метрикой.
Соня Хуанг (Sonya Huang) из Sequoia Capital признается Бускетту, что токенмаксинг — несовершенная метрика, которая, тем не менее, может быть необходима для быстрого внедрения LLM. В будущем я ожидаю появления множества оптимизаций и инструментов, созданных для решения проблемы выбора моделей и оптимизации контекстного окна.
Опубликовано 27 августа 2026 - 01:08 Наверх