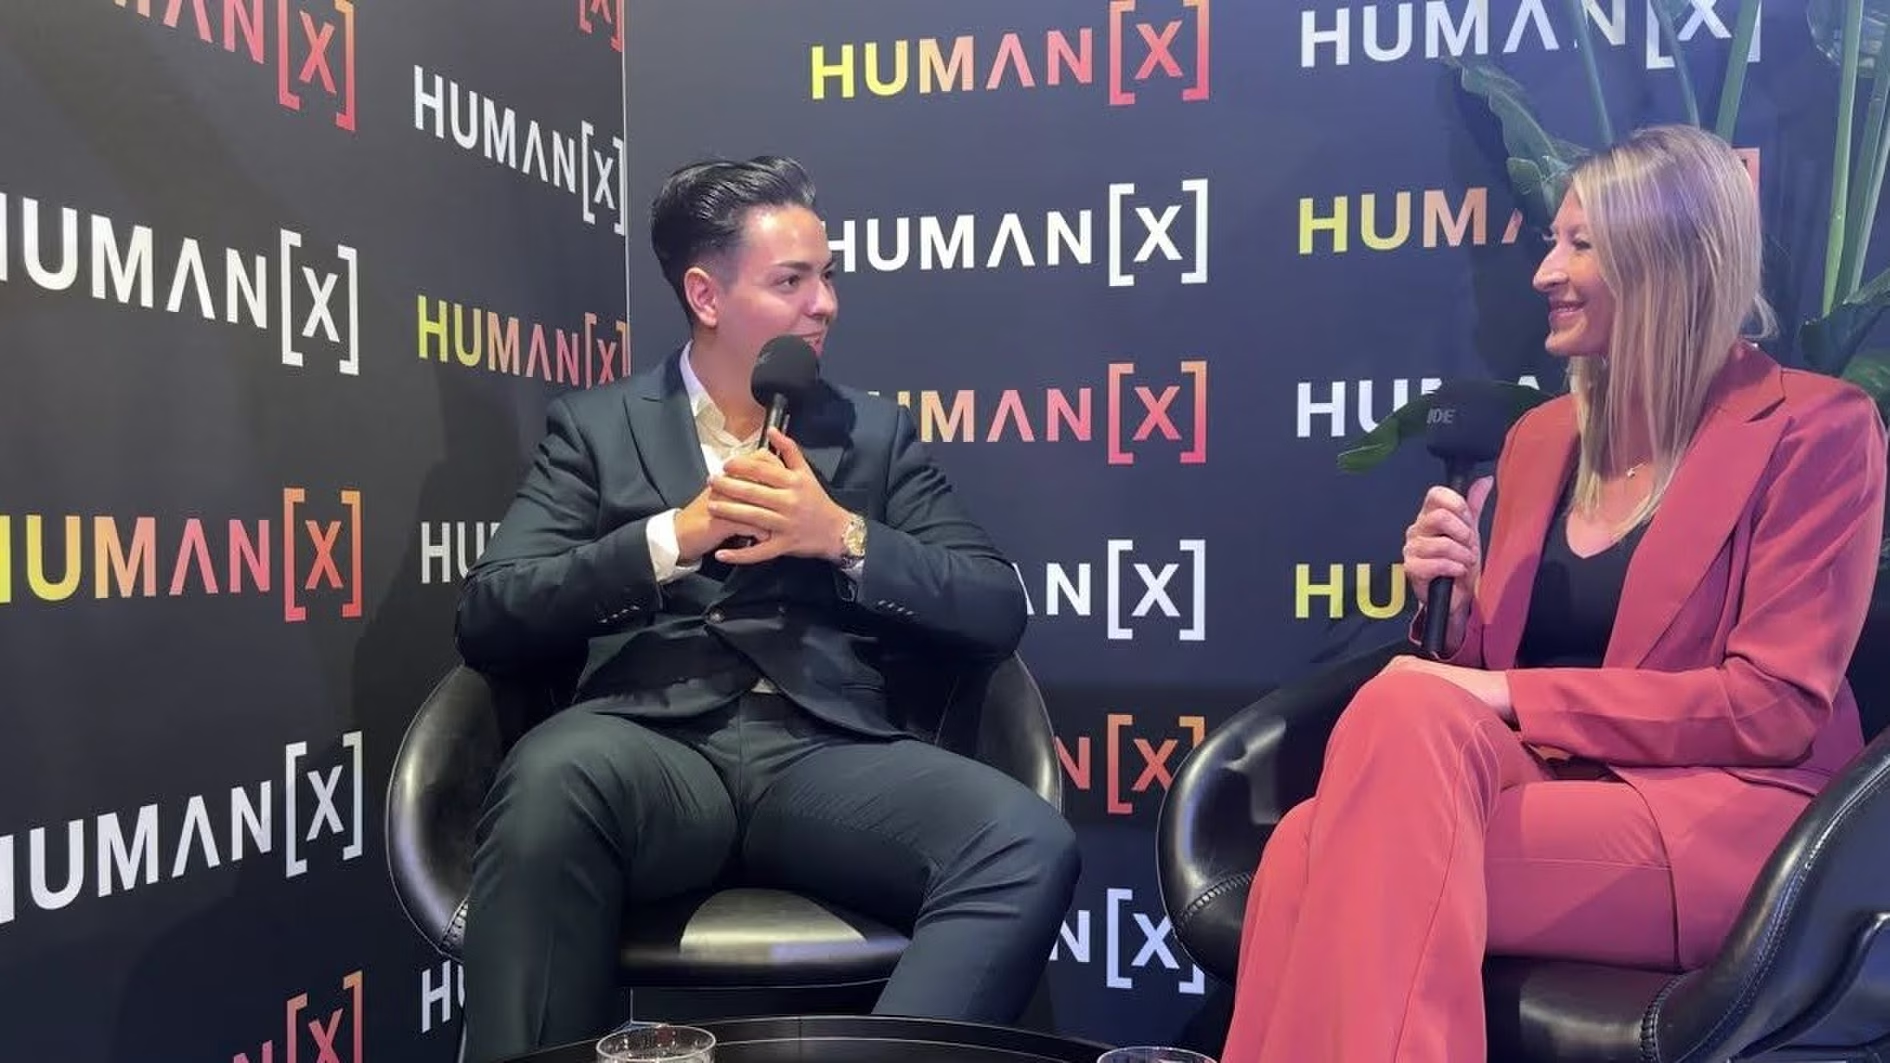
Бернс — старший директор по PR и коммуникациям в Bright Data. Компания продаёт инфраструктуру для работы с веб-данными — инструменты, которые собирают публичные данные из интернета для ИИ-моделей, агентов и маркетинговых исследований. Она пришла в компанию три с половиной года назад, проработав 20 лет журналистом в местных СМИ.
Она побеседовала с Кристианом Диной на HumanX в Амстердаме для подкаста TNW. Гостями предыдущих выпусков были Авани Прабхакар из Atlassian и Йоб ван дер Воорт из Remote. Полная версия разговора — в видео ниже.
Публичное — значит без авторизации
Позиция Bright Data однозначна, говорит Бернс. Данные за авторизацией не являются публичными, а всё остальное — является.
«Если вы делаете что-то доступным для любого человека, это должно быть доступно и для ИИ. Здесь действительно нельзя выбирать, кто сможет просматривать эти данные и в каком масштабе». Дженнифер Бернс, Bright Data
Кристиан изложил ей позицию издателей: они тратят деньги и ресурсы на создание контента, а затем агенты его собирают. Её ответ остался прежним. Издатель, недовольный агентами, может закрыть контент за авторизацией и сам решать, кого впускать.
«Я думаю, это реальная проблема, и рынку ещё предстоит её урегулировать, но решать, как именно это произойдёт, не нам». Дженнифер Бернс
Похожая борьба идёт и в других местах. На прошлой неделе Reddit заявил, что обяжет пользователей входить в аккаунт. В понедельник New York Times и ещё три американские газеты подали в суд на Brave из-за скрейпинга.
X и Meta в суде
Bright Data уже судилась с Meta и X из-за сбора их данных. По словам Бернс, иск подала X, и Bright Data защищалась, как в любом другом деле. Она отметила, что суды подтвердили законность деятельности компании.
«Всё остальное, что вы пытаетесь делать, не проводя чёткого различия между публичными и непубличными данными, — это форма ограничения доступа». Дженнифер Бернс
Роботы учатся по интернету
По словам Бернс, сейчас у Bright Data 50 000 клиентов — против 20 000 на момент её прихода. Компания обслуживает 14 из 20 ведущих LLM и обрабатывает 100 миллионов взаимодействий с агентами в день. Штат вырос примерно с 250 до около 600 человек, а недавно компания наняла нового технического директора.
В конце 2025 года робототехнические компании начали запрашивать у Bright Data публичные данные для обучения, рассказала Бернс. Некоторые хотели увидеть, как люди берут в руки стакан. Им нужны были стаканы разных размеров, тени и домашнее освещение, а также разные способы поставить стакан на столешницу. Снимать всё это пришлось бы целую вечность, говорит она, но в интернете это уже есть.
В начале 2026 года компания активно занялась контекстным слоем. Это данные в реальном времени, которые сообщают агенту, что происходит сейчас, — например, актуальные цены. Без них ответ LLM или агента, по её словам, «по сути бесполезен».
Пять агентов и человек
Сама Бернс использует в работе пять ИИ-агентов.
«Это не значит, что я становлюсь менее нужной. Это делает меня более нужной, потому что мне приходится управлять этими агентами. Я не могу позволить им работать без участия человека». Дженнифер Бернс
По её словам, Bright Data бесплатно предоставляет свои инструменты журналистам в рамках специальной программы. Она надеется, что журналисты будут быстрее осваивать ИИ. Её совет ИИ-компаниям в области PR — понимать свою историю, владеть ею и хорошо её объяснять. И каждый сотрудник компании должен уметь делать то же самое.
«Не разбрасывайтесь словом ИИ ради самого ИИ. Сейчас всё — ИИ». Дженнифер Бернс
Опубликовано 3 ноября 2026 - 00:56 Наверх